Iti0210lab10: erinevus redaktsioonide vahel
Resümee puudub |
Resümee puudub |
||
| 18. rida: | 18. rida: | ||
Kõigepealt loe läbi [''AIMA''] 15.2.1 "Filtering and prediction", vajadusel mitu korda. Kokkuvõtlikult: | Kõigepealt loe läbi [''AIMA''] 15.2.1 "Filtering and prediction", vajadusel mitu korda. Kokkuvõtlikult: | ||
# Meil on mingi tõenäosusjaotus sisemisele olekule [[Image:Iti0210lab10_f1.png]] | # Meil on mingi tõenäosusjaotus sisemisele olekule [[Image:Iti0210lab10_f1.png]]. Tahame leida tõenäosusjaotust järgmisel ajahetkel ''t+1'', kui me teame välist tunnust ''e<sub>t+1</sub>'' (antud juhul on selleks sõnumite sagedus). | ||
# Arvutame, mis | # Arvutame, mis üleminekumudel järmiseks olekuks annaks [[Image:Iti0210lab10_f2.png]]. Tegu on jaotuse valemiga, et programmis seda arvutada, tuleb aru saada, et ''X<sub>t+1</sub>'' on muutuja ning selle asemele tuleb kordamööda panna kõik tema võimalikud väärtused. | ||
# Kasutades emissioonimudelit, täpsustame sisemise oleku hinnangut [[Image:Iti0210lab10_f3.png]] | # Kasutades emissioonimudelit, täpsustame sisemise oleku hinnangut [[Image:Iti0210lab10_f3.png]]. ''e<sub>t+1</sub>'' on välise tunnuse konkreetne väärtus. | ||
# Normaliseerime. See tähendab, et | # Normaliseerime. See tähendab, et nüüd on õige hetk leida eelmises valemis olev [[Image:Iti0210lab10_f4.png]]. Näiteks, kui eelmises sammus arvutame numbrid <0.13, 0.21, 0.04>, siis need tuleks mingi arvuga läbi korrutada, et saada jaotus mille summa on 1. Seda arvu on üsna lihtne leida: 1 / (0.13 + 0.21 + 0.04). Saame lõpliku jaotuse <0.34, 0.56, 0.1>. | ||
Alguses on meil vaatlustulemuste seeria, aga sisemiste olekute jaotuseid pole. Võtame appi eeltõenäosuse (''prior'') ja väidame, et see on jaotus vahetult enne vaatlustulemuste seeriat. See on küll väga umbkaudne, aga esiteks pole midagi paremat võtta, teiseks mõjutab esimene jaotus sisemist olekut seeria lõpus palju vähem, kui seeria alguses. Meid huvitab just seeria lõpp ehk värskeim olek. | |||
Eeltõenäosuse ja esimese vaatlustulemuse pealt saame ülaltoodud sammudega arvutada esimese sisemise oleku jaotuse. Selle võtame aluseks järgmisele olekule jne, kuni jõuame iteratiivselt vaatlustulemuste seeria lõppu. | |||
== Algandmed == | == Algandmed == | ||
Redaktsioon: 25. november 2018, kell 20:32
Peidetud Markovi mudel
Sissejuhatus
Peidetud Markovi mudel (hidden Markov model, HMM) esitab mingit ajas muutuvat nähtust, mis käitub nagu Markovi ahel. Seejuures ei ole see nähtus meile otseselt vaadeldav, vaid me näeme ainult mingit kaudset tunnust. Vt. Wikipedia näide.

Ülesandes rakendame HMM-i sotsiaalvõrgu suhetele. Sõbraseosed sotsiaalvõrgus moodustavad graafi. Staatilisel kujul annab see graaf mingi ettekujutuse inimestevahelistest seostest, aga sõbraseoseid võib olla ka inimeste vahel, kes ei ole kunagi suhelnud ega kohtunud. Täpsema ettekujutuse suhetest saame, kui me jälgime ka sõnumite liikumist mööda graafi kaari ajas.
Võtame aluseks lähenemise, kus suhted sotsiaalvõrgus liigitatakse kolme faasi: avastamine, edaspidi tähistatud E(xploration), ülalhoidmine M(aintenance) ja unustamine F(orgetting) [1]. Kui leiame graafil kaared, mis on avastamise või ülalhoidmise faasis, siis see võiks anda meile inimese praeguse ja lähituleviku sõpruskonna.
Lähtume oletusest, et sõnumite arv ajaühikus on tingitud suhte faasist. Selle abil ehitame peidetud Markovi mudeli ning leiame Forward-algoritmiga praeguse oleku. Tegu on mänguülesandega, päris sotsiaalvõrgu andmeid ei kasutata.
Forward algoritm
Kõigepealt loe läbi [AIMA] 15.2.1 "Filtering and prediction", vajadusel mitu korda. Kokkuvõtlikult:
- Meil on mingi tõenäosusjaotus sisemisele olekule
 . Tahame leida tõenäosusjaotust järgmisel ajahetkel t+1, kui me teame välist tunnust et+1 (antud juhul on selleks sõnumite sagedus).
- Arvutame, mis üleminekumudel järmiseks olekuks annaks
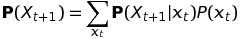 . Tegu on jaotuse valemiga, et programmis seda arvutada, tuleb aru saada, et Xt+1 on muutuja ning selle asemele tuleb kordamööda panna kõik tema võimalikud väärtused.
- Kasutades emissioonimudelit, täpsustame sisemise oleku hinnangut
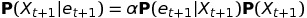 . et+1 on välise tunnuse konkreetne väärtus.
- Normaliseerime. See tähendab, et nüüd on õige hetk leida eelmises valemis olev
 . Näiteks, kui eelmises sammus arvutame numbrid <0.13, 0.21, 0.04>, siis need tuleks mingi arvuga läbi korrutada, et saada jaotus mille summa on 1. Seda arvu on üsna lihtne leida: 1 / (0.13 + 0.21 + 0.04). Saame lõpliku jaotuse <0.34, 0.56, 0.1>.


Alguses on meil vaatlustulemuste seeria, aga sisemiste olekute jaotuseid pole. Võtame appi eeltõenäosuse (prior) ja väidame, et see on jaotus vahetult enne vaatlustulemuste seeriat. See on küll väga umbkaudne, aga esiteks pole midagi paremat võtta, teiseks mõjutab esimene jaotus sisemist olekut seeria lõpus palju vähem, kui seeria alguses. Meid huvitab just seeria lõpp ehk värskeim olek.
Eeltõenäosuse ja esimese vaatlustulemuse pealt saame ülaltoodud sammudega arvutada esimese sisemise oleku jaotuse. Selle võtame aluseks järgmisele olekule jne, kuni jõuame iteratiivselt vaatlustulemuste seeria lõppu.
Algandmed
Üleminekumudel:
    H   C
 H  0.7 0.3
 C  0.3 0.7
Emissioonimudel (sõnumite sageduse tõenäosusjaotus, kui seose olek on antud):
    S   M   L
 H  0.1 0.4 0.5
 C  0.7 0.2 0.1
Eeltõenäosused
Lahendus
Viited
- Yang, Z., Xue, J., Wilson, C., Zhao, B.Y. and Dai, Y. (2015) Uncovering User Interaction Dynamics in Online Social Networks. Proceedings of the 9th International Association for the Advancement of Artificial Intelligence (AAAI) Conference on Web and Social Media, Oxford, 26-29 May 2015, 698-701.